هل تثق بإجابة الذكاء الاصطناعي؟ مشكلة المصادر والاقتباس
إجابة الذكاء الاصطناعي تصل مصقولة، وواثقة، ومليئة بالمصادر، فتبدو كأنها حقيقة، لكن الدراسات تكشف أن هذه المصادر كثيراً ما تكون مفقودة، أو ملفقة، أو منسوبة من مصدر خاطئ. كيف تكتشف الأنواع الثلاثة للمصدر الخاطئ، وتتحقق بنفسك من صحة الإجابة؛ لتجعل عملك مصدراً يقتبسه الذكاء الاصطناعي بدقة.
8 دقيقة قراءة
— خلاصة —
إجابة الذكاء الاصطناعي تصل مصقولة، وواثقة، ومليئة بالمصادر، فتبدو كأنها حقيقة، لكن الدراسات تكشف أن هذه المصادر كثيراً ما تكون مفقودة، أو ملفقة، أو منسوبة من مصدر خاطئ. كيف تكتشف الأنواع الثلاثة للمصدر الخاطئ، وتتحقق بنفسك من صحة الإجابة؛ لتجعل عملك مصدراً يقتبسه الذكاء الاصطناعي بدقة.
— النصّ الكامل —
في المقالة السابقة، تحدثنا عن تحول يبدو صغيرًا، لكنه عميق الأثر، فلم يعد الذكاء الاصطناعي يعطيك قائمة روابط تختار منها وحسب؛ بل أصبح يعطيك إجابة واحدة وجاهزة، ولكن يبقى لدينا سؤال: هل يمكننا الثقة بمصادر هذه الإجابة؟
الإجابة تصلنا مصقولة، لغتها واثقة، مؤكدة بأرقام ومصادر وروابط. كل شيء فيها يوحي بأنها محققة ومدققة. وهنا تكمن المشكلة: فشكل الإجابة يبدو موثوقاً أكثر مما هو عليه فعلاً.
فإجابة مكتوبة بثقة قد تكون خاطئة، ومصدر مذكور في الأسفل قد لا يصح ما نُسب إليه أصلاً، بل قد يكون المصدر نفسه غير موجود.
لماذا تبدو الإجابة موثوقة أكثر مما هي عليه؟
لماذا نثق بالإجابة بهذه السهولة؟ لأنها تحمل كل علامات الموثوقية الظاهرية، فالصياغة سليمة، والنبرة هادئة وواثقة، وهناك مصادر مرفقة نستطيع النقر عليها. كل هذا يعطي انطباعاً بأن أحداً ما تحقق من المعلومة قبل وصولها إلينا.
لكن أحداً لم يتحقق، فالنموذج لا يعرف الحقيقة، وإنما يركب الكلمات بطريقة مقنعة، ثم يضيف مصادر تبدو مناسبة، فالمصدر عنده ليس دائما دليلاً على صحة المعلومة، بل أحيانا مجرد زينة؛ لتكمل شكل الإجابة.
دقق باحثون من جامعة ستانفورد في إجابات أربعة من محركات الذكاء الاصطناعي، فتبين لهم أن نصف الجمل تقريباً لم تستند إلى أي مصدر حقيقي، وحتى حين يُذكر مصدر بعينه، فإن نحو ربعه لم يكن يقول فعلا ما نُسب إليه. أي أن الجواب يبدو مدعوماً بالمصادر، بينما نصفه بلا سند حقيقي.
الباحثون أنفسهم سموا هذا "قناع الموثوقية": مظهر خارجي يوحي بالثقة، دون أن يكون خلفه ما يبررها.
ماذا تقول الأرقام؟
قد نظن أنها مشكلة قديمة زالت مع تطور الأدوات، لكن الأرقام الأحدث تقول غير ذلك.
في مطلع عام 2025، أجرى مركز "تاو" للصحافة الرقمية في جامعة كولومبيا اختباراً على ثمانية من محركات البحث بالذكاء الاصطناعي، طرح عليها مقاطع من مقالات حقيقية، وطلب منها تحديد مصدر كل مقطع. النتيجة: أخطأت المحركات في أكثر من 60% من الحالات، وبعضها أخطأ في 90% تقريباً.
والأهم من نسبة الخطأ هو سلوك المحركات عند الخطأ، فهي نادراً ما قالت "لا أعرف". بدل ذلك، أعطت إجابة واثقة وخاطئة، وأحد المحركات أعطى نسباً خاطئة في أكثر من مئة وثلاثين حالة من أصل مئتين، ولم يبدِ أي شك إلا في عدد قليل منها.
وهناك مفارقة تستحق الانتباه: النسخ المدفوعة لم تكن أدق، بل كانت أكثر ثقة في إجاباتها الخاطئة من النسخ المجانية، أي أنك تدفع أكثر، فتحصل على نبرة أكثر حزماً، لا على دقة أعلى.
ولا تقتصر المشكلة على اللغة الإنجليزية، ففي دراسة دولية قادتها هيئة الإذاعة البريطانية (BBC) واتحاد البث الأوروبي، شملت اثنتين وعشرين مؤسسة إعلامية وأربعة عشر لغة، ظهر أن نحو نصف الإجابات فيها مشكلة جوهرية، وأن ثلثها تقريباً يحمل خطأ في المصدر، أو في نسب المعلومة، المشكلة إذاً عابرة للغات، وتخص القارئ العربي كما تخص غيره.
أين ينكسر الاقتباس؟
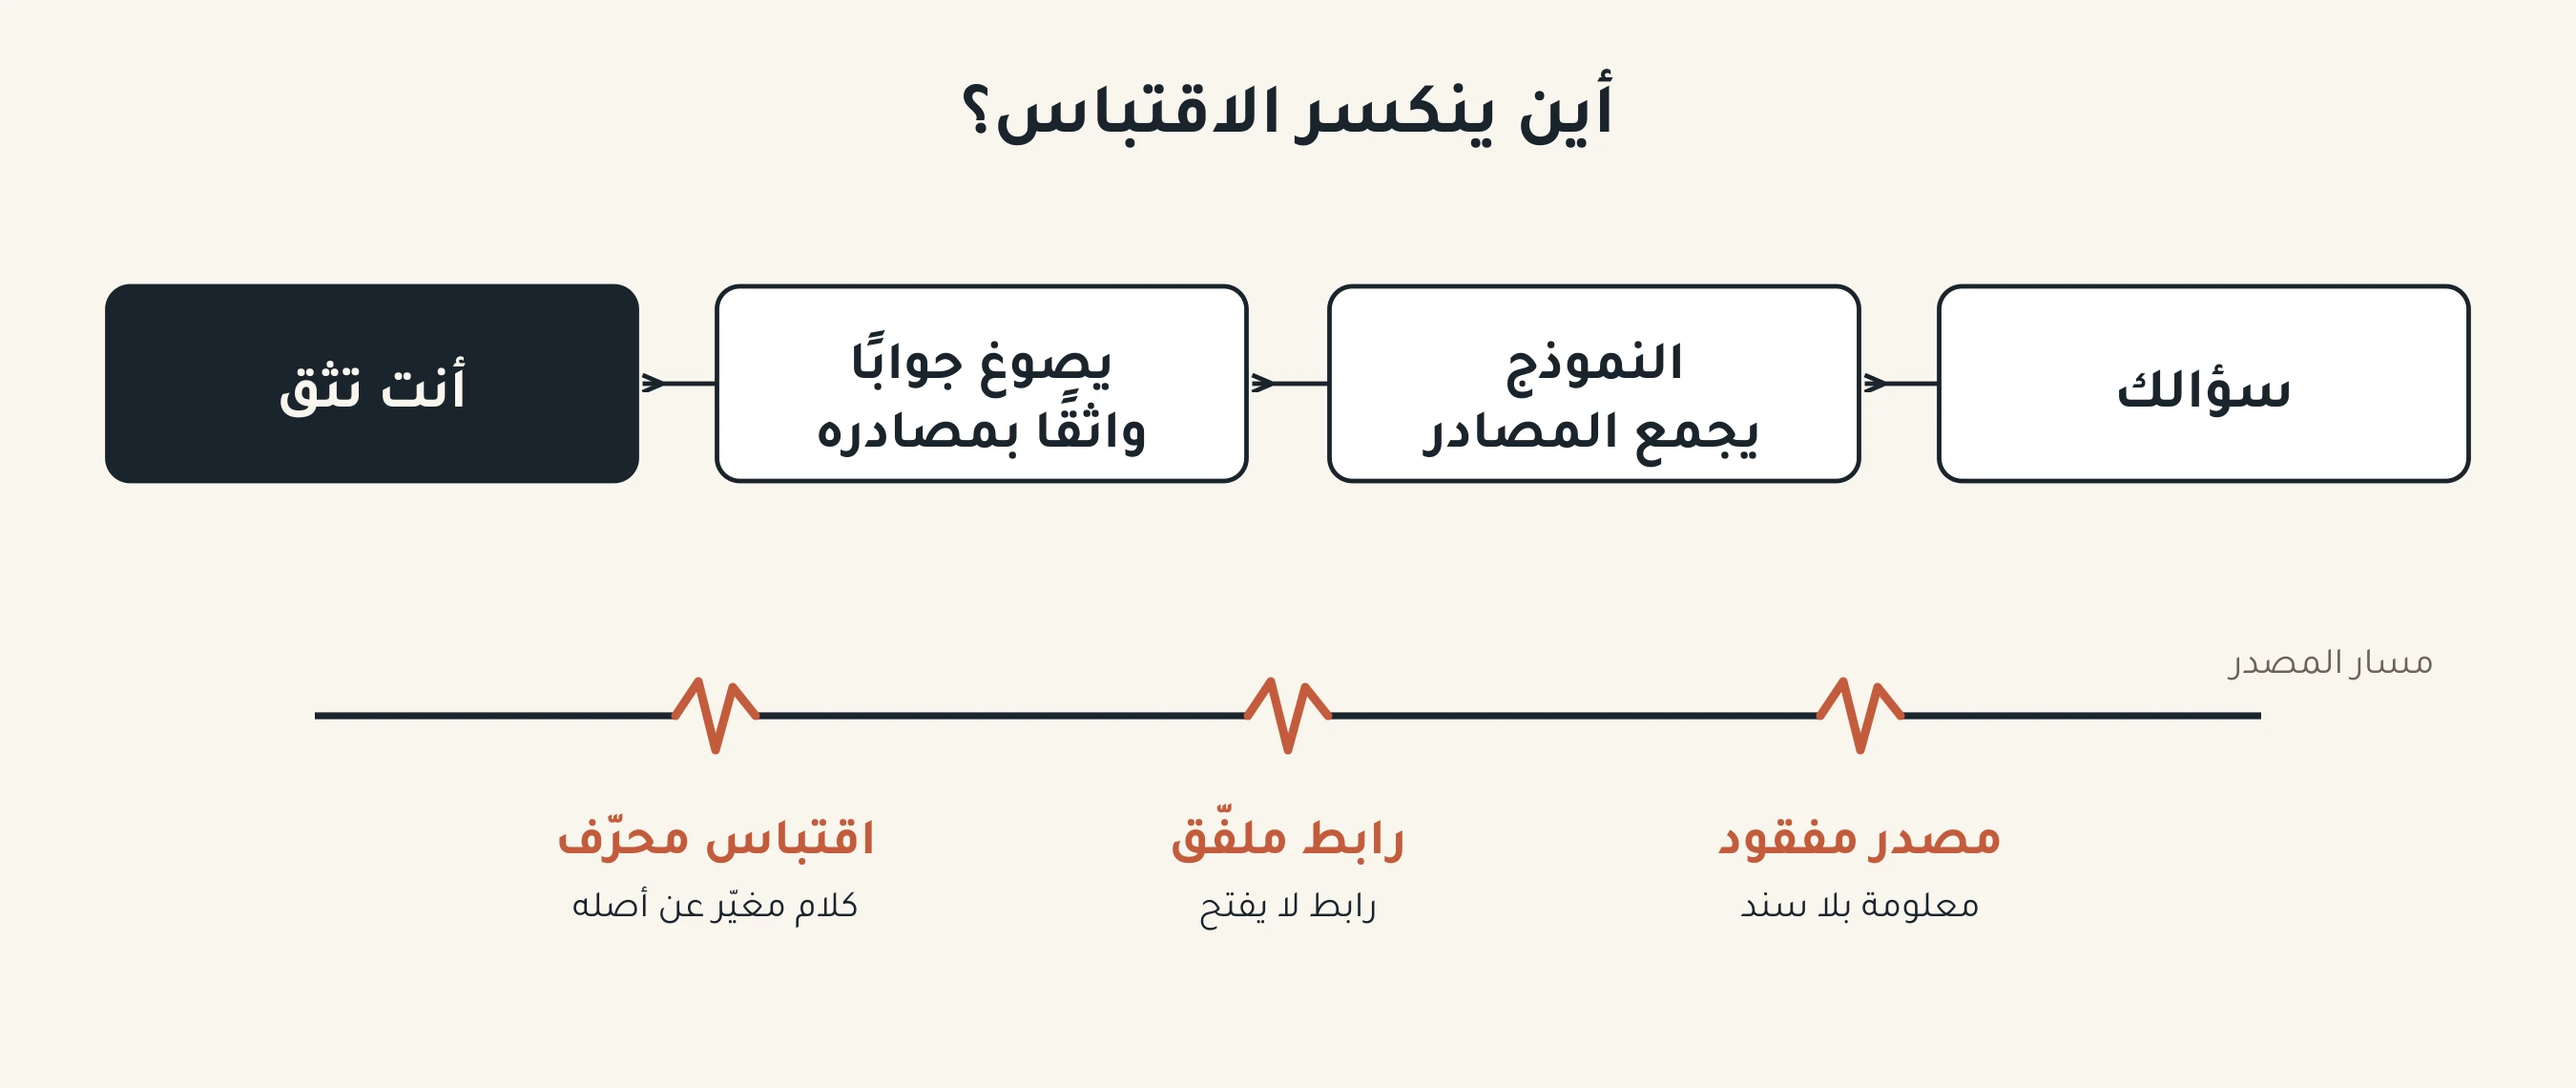 *شكل: المسار من سؤالك إلى ثقتك بالإجابة، والنقاط الثلاثة التي ينكسر عندها الاقتباس.*
حين نقول إن المصدر "خاطئ"، فنحن لا نتحدث عن خطأ واحد، بل عن ثلاثة أنواع مختلفة، ومن المفيد أن تعرفها، لأنك ستراها بنفسك.
النوع الأول: مصدر مفقود. الإجابة تذكر معلومة، لكن لا يرفق بها أي مصدر يسندها، فالمعلومة قد تكون صحيحة، أو خاطئة، لكنك لا تملك طريقة للتحقق. فهي معلقة بلا سند.
النوع الثاني: رابط ملفق. الإجابة تعطيك رابطاً يبدو حقيقياً تماماً، باسم موقع معروف، وعنوان مقنع، لكنك حين تفتحه، تجد صفحة خطأ، أو صفحة لا علاقة لها بالموضوع. الرابط غير موجود أصلاً؛ ركّبه النموذج ليكمل الشكل.
النوع الثالث: اقتباس محرّف. الإجابة تنسب كلاماً إلى مصدر حقيقي، لكن المصدر لم يقل هذا الكلام، أو قاله بصيغة مختلفة، أو في سياق معاكس. في الدراسة البريطانية، تبين أن جزءاً من الاقتباسات المنسوبة إلى مصادر حقيقية كان محرفاً عن أصله، فالاسم صحيح، والكلام مغلوط.
مثال من العالم الحقيقي
قد تبدو هذه الأخطاء تفصيلاً تقنياً، حتى تصطدم بها في موقف حقيقي.
عام 2023، أعد محام في نيويورك مذكرة قانونية لمحكمة فدرالية. استعان في بحثه بأداة ذكاء اصطناعي، فأعطته ستة قضايا سابقة تدعم موقف موكله، بأسماء وأرقام واقتباسات كاملة، بدت القضايا حقيقية تماماً، والمشكلة أنها لم تكن موجودة. اخترعها النموذج بالكامل.
والتفصيل الأخطر في القصة: حين بدأ بالشك، سأل المحامي الأداة نفسها إن كانت القضايا حقيقية. فأكدت له أنها حقيقية، فكانت تلك كذبة ثانية تفوق الأولى. انتهى الأمر بغرامة على المحامي ومكتبه، وبقضية صارت مثالا يُدرّس عن مخاطر الثقة العمياء بإجابة واثقة.
قد تقول إن هذا خطأ فردي من مستخدم لم يتحقق، لكن حتى الأدوات المصممة خصيصاً لهذا المجال ليست بمنأى عن المشكلة. فحصت جامعة ستانفورد أدوات بحث قانوني احترافية، بعضها يُسوّق صراحة على أنه "خال من الهلوسة" (أي لا يخترع معلومات). النتيجة أن هذه الأدوات كانت تختلق معلومات في ما بين سُبع وثُلث الحالات. الوعد كان أكبر من الواقع.
الدرس هنا بسيط: كلما ارتفعت المخاطر، ارتفعت الحاجة إلى التحقق بنفسك.
كيف تختلف المحركات في التعامل مع المصادر
لا تتعامل كل المحركات مع المصادر بالطريقة نفسها. الجدول التالي يلخص، بحسب الدراسات المذكورة، كيف يعرض كل منها مصادره، وأين يكمن ضعفه، وماذا يعني ذلك لك عملياً.
| المحرك | كيف يعرض مصادره؟ | أين يضعف؟ | ماذا يعني لك؟ |
|---|---|---|---|
| ChatGPT (بحث) | يكتب ملخصًا ويضيف روابط في الأسفل | نسب المعلومات إلى مصادرها الخطأ في نحو ثلثي الحالات، ونادرًا ما قال إنه غير متأكد | لا تصدّق نسبة المعلومة لمصدرها قبل أن تفتح الرابط |
| Google (نظرة عامة بالذكاء الاصطناعي) | يعرض ملخصًا أعلى نتائج البحث | يتبع ترتيب نتائج البحث نفسه، فيضعف حين تكون المصادر قليلة | ارجع إلى المصدر الأصلي، لا إلى الملخص |
| Perplexity | يعرض مصادر مرقّمة بجانب الإجابة | نسب في إحدى الحالات كلامًا إلى مصدر لم يقله فعلًا | وجود رقم المصدر لا يعني أن الكلام موجود فيه |
| Gemini | يكتب ملخصًا مع ذكر مصادره | كان الأكثر خطأً في المصادر بين المحركات التي جرى اختبارها | تحقّق منه مرتين قبل الاعتماد عليه |
| Grok | يبحث لحظيًا ويضيف المصادر | كان الأكثر خطأً في الاقتباس بين المحركات التي جرى اختبارها | هو الأضعف حاليًا في دقة المصادر |
القاعدة المشتركة بين الصفوف جميعها واحدة، وهي: وجود المصدر لا يعني صحته. المصدر المرقّم، أو الرابط الأزرق، أو اسم الموقع المعروف، كلها إشارات شكلية، الدليل الوحيد هو أن تفتح المصدر وتقرأه.
كيف تتحقق بنفسك
لا تحتاج إلى خبرة تقنية لتتحقق، بل تحتاج إلى عادة بسيطة من أربع خطوات:
افتح الرابط قبل أن تصدقه. لا تكتفِ بوجوده، فالمصدر الذي لا تفتحه لا قيمة له.
قارن الاقتباس بالأصل. إن نسبت الإجابة كلاماً إلى جهة ما، فابحث عن الكلام في مصدره. تأكد أنه موجود، وأنه قيل في سياقه الصحيح.
فضّل المصدر الأول. الموقع الرسمي، أو الدراسة الأصلية، أو الجهة صاحبة المعلومة، أفضل من موقع ينقل عنها.
اطلب المصادر صراحة. حين تسأل الذكاء الاصطناعي، اطلب منه أن يذكر مصادره وروابطها، ثم افتحها. مجرد طلبك للمصادر يجعل الإجابة أكثر قابلية للفحص.
هذه الخطوات لا تستغرق دقائق، لكنها الفرق بين أن تبني قرارك على معلومة، أو على وهم معلومة.
ماذا يعني هذا لك كصاحب عمل
إلى هنا تحدثنا إليك بصفتك قارئا. لكن إن كنت صاحب عمل، أو علامة تجارية، فالمسألة لها وجه آخر يخصك مباشرة.
إن كان الذكاء الاصطناعي يخطئ في نسب المعلومات نصف الوقت، فهذا يعني أنه قد يخطئ في وصف شركتك أيضا، قد ينسب إليك خدمة لا تقدمها، أو سعرا خاطئاً، أو معلومة قديمة. والأسوأ أن يذكرك بثقة، وبشكل خاطئ، وأن يُذكر اسمك بمعلومة خاطئة أسوأ من ألا يُذكر إطلاقًا.
ما العمل؟ اجعل نفسك مصدراً يسهل على الذكاء الاصطناعي أن يقتبسه بدقة، وذلك يتحقق بأمور واضحة:
معلومات ظاهرة وصريحة. اكتب ما تريد أن يُقال عنك بوضوح على موقعك، في نص مقروء، لا مخفياً في صورة، أو ملف. النماذج تقرأ النص الظاهر.
بيانات دقيقة وحديثة. أسعارك، خدماتك، أرقامك، حدّثها. المعلومة القديمة على موقعك قد تعود إليك في إجابة خاطئة.
مرجع واضح عن نفسك. اجعل موقعك المصدر الأول لأي معلومة عنك، بصيغة سهلة الاقتباس: سؤال وجواب، جدول، أو تعريف مباشر.
وهنا ملاحظة أمينة، لأنها شائعة الخطأ في سوق التسويق: البيانات المنظمة التي توضع خلف الكواليس في شيفرة الموقع (schema) مفيدة لأسباب أخرى، لكنها وحدها لا تشتري لك اقتباساً من الذكاء الاصطناعي. أظهرت دراسة حديثة أن إضافتها لم ترفع نسبة الاقتباس. ما يرفعها هو محتوى ظاهر، وموثوق وقابل للفحص، وسمعة تجعل موقعك جديراً بالثقة. لا تنفق جهدك على الحيل التقنية، بل على كونها فعلاً مصدراً يستحق الاقتباس.
في الختام
عدنا إذاً إلى النقطة نفسها التي بدأنا منها. الذكاء الاصطناعي أداة قوية، لكنها ليست معصومة. الإجابة الواثقة ليست بالضرورة إجابة صحيحة، والمصدر المذكور ليس بالضرورة مصدراً حقيقياً.
الفرق بين من يستفيد من هذه الأدوات ومن تخدعه ليس في ذكاء الأداة، بل في عادة بسيطة، وهي: فتح المصدر قبل تصديقه. فالثقة تُبنى على التحقق، لا على حسن الظاهر.
المصادر
- Liu, Zhang & Liang (2023). "Evaluating Verifiability in Generative Search Engines." ACL Findings (EMNLP 2023) — نصف الجمل تقريبا مدعوم بالكامل (51.5%)، و74.5% فقط من الاقتباسات تدعم فعلا جملتها، عبر أربعة محركات. https://aclanthology.org/2023.findings-emnlp.467/
- مركز تاو للصحافة الرقمية في جامعة كولومبيا (2025). "AI Search Has a Citation Problem." — ثمانية محركات أخطأت أكثر من 60% من الوقت، وأحدها أخطأ في 134 من أصل 200 حالة ونادرا ما اعترف بالشك، والنسخ المدفوعة كانت أكثر ثقة في أجوبتها الخاطئة. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
- BBC (2025). "AI chatbots unable to accurately summarise news." — 51% من الأجوبة فيها مشكلة جوهرية، و13% من الاقتباسات محرفة أو غير موجودة. https://www.bbc.com/news/articles/c0m17d8827ko
- اتحاد البث الأوروبي وBBC (2025). دراسة دولية شملت 22 مؤسسة إعلامية و14 لغة — 45% من الأجوبة فيها مشكلة جوهرية، و31% خطأ في المصدر، وGemini الأعلى بمشكلات المصادر. https://www.aljazeera.com/news/2025/10/22/ai-models-misrepresent-news-events-nearly-half-the-time-study-says
- Magesh, Surani, Dahl, Suzgun, Manning & Ho، جامعة ستانفورد (2025). "Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools." Journal of Empirical Legal Studies — أدوات مسوّقة كـ"خالية من الهلوسة" هلوست في 17% إلى 33% من الحالات. https://onlinelibrary.wiley.com/doi/full/10.1111/jels.12413
- Mata v. Avianca, Inc.، محكمة نيويورك الفدرالية (2023) — محامٍ استند إلى ست قضايا ملفقة من ChatGPT، وغُرّم 5,000 دولار بعد أن أكدت له الأداة زورا أنها حقيقية. https://en.wikipedia.org/wiki/Mata_v._Avianca,_Inc.
- Ahrefs (2026). دراسة حول البيانات المنظمة (schema) والاقتباس بالذكاء الاصطناعي — إضافة السكيما لم ترفع نسبة الاقتباس؛ ما يرفعها المحتوى الظاهر الموثوق. https://ahrefs.com/blog/schema-ai-citations
— أسئلة شائعة —
- هل مصادر الذكاء الاصطناعي موثوقة؟
- ليست دائما. أظهرت دراسات متعددة أن نسبة كبيرة من المصادر التي يرفقها الذكاء الاصطناعي إما مفقودة، أو ملفقة، أو لا تقول فعلا ما نُسب إليها. وجود المصدر لا يعني صحته؛ الطريقة الوحيدة للتأكد هي فتح المصدر وقراءته.
- لماذا يخترع الذكاء الاصطناعي مصادر غير موجودة؟
- لأن النموذج لا يبحث عن الحقيقة، بل يركب كلاما يبدو مقنعا. وحين لا يجد مصدرا حقيقيا، قد يركّب رابطا أو مرجعا يشبه الحقيقي في شكله. تسمى هذه الظاهرة الهلوسة (hallucination).
- كيف أتحقق من صحة معلومة أعطاني إياها الذكاء الاصطناعي؟
- افتح الرابط الذي أعطاك إياه بنفسك، وقارن الاقتباس بمصدره الأصلي، وفضّل المصدر الأول على من ينقل عنه، واطلب من الأداة أن تذكر مصادرها صراحة ثم افحصها.
- هل النسخ المدفوعة أدق من المجانية؟
- ليس بالضرورة. أظهر أحد الاختبارات أن النسخ المدفوعة كانت أحيانا أكثر ثقة في أجوبتها الخاطئة، لا أكثر دقة. السعر الأعلى يشتري نبرة أكثر حزما، لا صحة مضمونة.
- كيف أجعل شركتي مصدرا يقتبسه الذكاء الاصطناعي بدقة؟
- انشر معلوماتك بوضوح في نص مقروء على موقعك، وحدّث بياناتك باستمرار، وقدّمها بصيغة سهلة الاقتباس مثل سؤال وجواب أو جدول. الأهم أن تكون معلومتك ظاهرة وموثوقة، لا مخفية أو معتمدة على حيل تقنية.
الكاتب
Youssef Sadaki
استراتيجيٌّ سوريٌّ-كنديٌّ في التحوّل الرقمي ومحلّلٌ لشؤون الشرق الأوسط، يقيم بين لندن (أونتاريو) ودمشق. نُشرت كتاباته في مجلس الأطلسي ومعهد واشنطن للسياسات في الشرق الأدنى ومؤسّسة القرن وجدلية، وفي منابر عربية بينها 7al.net.